2018年中国人工智能基础资源与技术发展研究报告
一、引言
2018年,中国人工智能产业在政策、资本和技术创新的多重驱动下进入快速发展期。基础资源与技术作为人工智能产业的底层支撑,决定了上层应用的高度与广度。本报告聚焦2018年中国人工智能基础资源(数据、算力、算法)与关键技术(机器学习、计算机视觉、语音识别、自然语言处理等)的发展现状、主要进展与面临挑战,为产业参与者提供参考。
二、人工智能基础资源发展现状
2.1 数据资源
数据是人工智能的“燃料”。2018年,中国拥有全球最庞大的互联网用户群体和丰富的应用场景,产生了海量数据。据中国互联网络信息中心(CNNIC)统计,截至2018年6月,中国网民规模达8.02亿,互联网普及率为57.7%。移动互联网、物联网、社交媒体、电子商务等持续产生结构化与非结构化数据,为人工智能模型训练提供了基础。
在数据标注产业方面,中国涌现出大量专业数据标注服务公司,形成了较为完整的产业链。政府和企业积极推动公共数据开放,如国家数据共享交换平台、各地大数据交易所等,但数据孤岛、数据质量参差不齐、隐私保护等问题依然突出。
2.2 计算资源
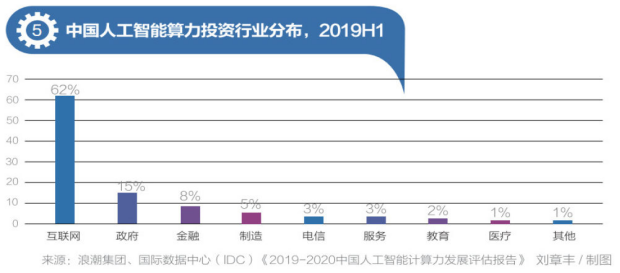
算力是人工智能发展的核心基础设施。2018年,中国在AI芯片、云计算平台、超算中心等方面取得显著进展。
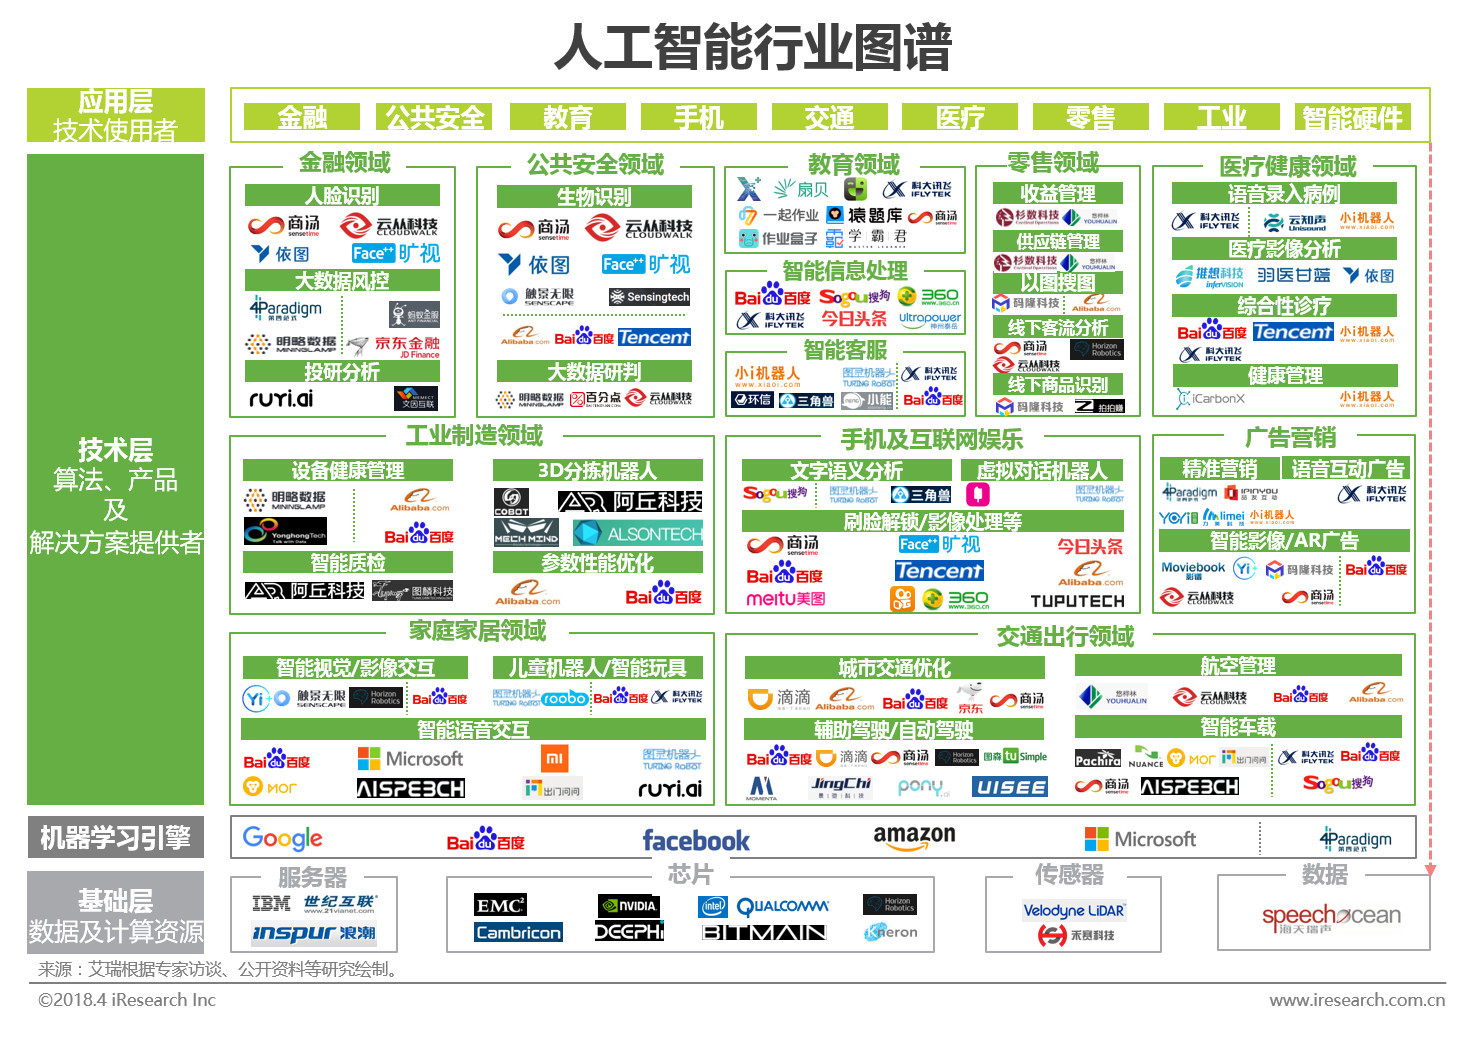
- AI芯片:传统芯片巨头如英伟达、英特尔仍占据主导地位,但国内企业如寒武纪、华为海思、地平线、比特大陆等推出了面向云端和终端的AI芯片。寒武纪发布MLU100云端智能芯片;华为发布昇腾310和910芯片,并推出全栈AI解决方案;地平线发布征程和旭日系列芯片。
- 云计算平台:阿里云、腾讯云、百度云、华为云等均提供GPU/FPGA加速的AI计算服务,推出机器学习平台和AI开放平台。
- 超算中心:国家超级计算中心(天津、广州、深圳等)为AI研究提供高性能计算支持。
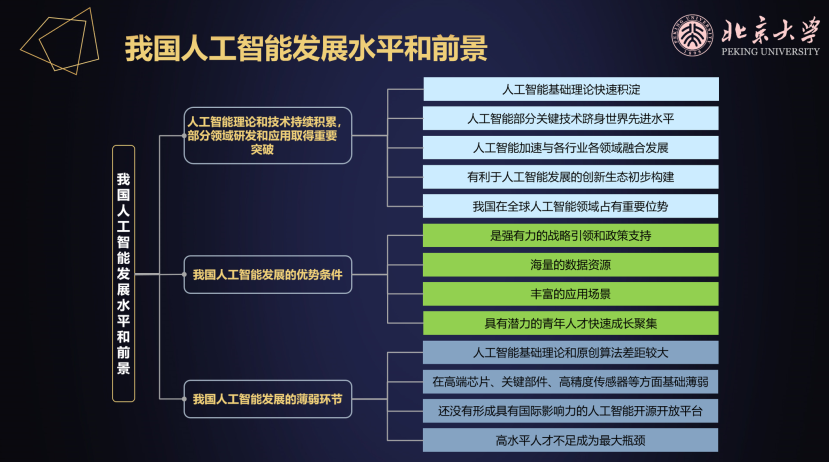
高端芯片仍严重依赖进口,核心算力受制于人的局面尚未根本改变。
2.3 算法与开源框架
算法是人工智能的灵魂。2018年,深度学习仍是主流算法方向,强化学习、迁移学习、生成对抗网络等取得进展。中国企业和研究机构在算法创新方面表现活跃,但原始创新仍相对不足。
开源框架方面,Google的TensorFlow和Facebook的PyTorch在全球占据主导地位。国内企业积极推出自主开源框架:百度发布PaddlePaddle(飞桨);华为推出MindSpore(2019年正式开源,但2018年已开始布局);阿里巴巴推出X-DeepLearning等。开源生态的建设有助于降低AI开发门槛,但国内框架在社区活跃度和生态完整性上与国外仍有差距。
三、关键技术发展分析
3.1 机器学习与深度学习
深度学习在图像识别、语音识别等领域取得超越人类的性能。2018年,中国研究团队在各项国际竞赛中屡获佳绩,如CVPR、ICCV等顶会论文数量快速增长。但基础理论创新(如新型神经网络结构、优化算法)仍以国外为主导。
3.2 计算机视觉
计算机视觉是中国人工智能技术落地最成熟的领域之一。人脸识别、图像分类、目标检测等技术达到国际先进水平。商汤、旷视、依图、云从等“AI四小龙”在人脸识别、安防、金融等领域实现大规模应用。2018年,计算机视觉在工业质检、医疗影像分析等方向开始探索。
3.3 语音识别与合成
语音识别准确率在通用场景下已超过95%,科大讯飞、百度、搜狗等企业在中文语音识别和合成方面具有领先优势。智能语音助手、智能音箱、车载语音等产品快速普及。但远场识别、嘈杂环境下的识别、多语种混合识别等仍是难点。
3.4 自然语言处理
自然语言处理(NLP)是人工智能的“皇冠明珠”。2018年,基于预训练语言模型(如BERT的发布)的技术变革刚刚开始。中国在机器翻译、文本分类、情感分析等方面有较多应用,但在深层语义理解、常识推理、低资源语言处理等方面与全球顶尖水平存在差距。
3.5 其他技术
- 知识图谱:在搜索、推荐、问答系统等领域应用广泛,但自动化构建和推理能力有限。
- 强化学习:在游戏、机器人控制等场景有研究突破,但实际落地案例较少。
- 边缘计算与AI:终端AI芯片和轻量化模型成为趋势,支撑手机、摄像头等设备的智能处理。
四、政策与产业环境
2018年,中国政府持续出台政策支持人工智能基础资源与技术发展。《新一代人工智能发展规划》进入实施阶段,科技部宣布依托百度、阿里云、腾讯、科大讯飞等建设国家新一代人工智能开放创新平台。工信部发布《促进新一代人工智能产业发展三年行动计划(2018-2020年)》,明确提出突破核心基础、加强算力与数据资源建设。
资本层面,2018年人工智能领域融资额保持高位,但早期投资趋于理性,资金更多流向有技术壁垒和落地场景的企业。
五、面临的主要挑战
- 基础理论薄弱:深度学习理论可解释性不足,类脑智能、量子智能等前沿方向研究投入不够。
- 核心硬件依赖:高端AI芯片(如GPU、FPGA)和半导体制造设备严重依赖进口,自主可控能力有待提升。
- 数据壁垒与隐私:数据质量不高、标准缺失、共享机制不健全,隐私保护法规尚不完善。
- 开源生态落后:国内开源框架起步晚,开发者社区规模小,国际影响力不足。
- 人才结构性短缺:高端算法人才和跨学科复合型人才缺口较大。
六、趋势与展望
- 算力需求将持续爆发,AI芯片将向专用化、边缘化方向发展,寒武纪、华为等企业有望进一步突破。
- 开源框架竞争加剧,国产框架将逐步完善生态,推动AI普惠化。
- 数据资源将更加注重治理与合规,数据安全法和个人信息保护法(2018年尚在立法过程中)将促进数据有序使用。
- 预训练模型和自监督学习将成为NLP和CV领域的新范式,推动技术进入新阶段。
七、
2018年是中国人工智能基础资源与技术承上启下的关键一年。数据与算力优势为产业发展提供了坚实基础,部分关键技术达到国际先进水平,但在基础理论、核心硬件、开源生态等方面仍存在明显短板。需加强产学研协同,突破底层技术瓶颈,构建自主可控的人工智能基础资源与技术体系。
如若转载,请注明出处:http://www.mayuhong888.com/product/39.html
更新时间:2026-10-31 02:37:05